2026-11-03 · Fonte:虎嗅·中继
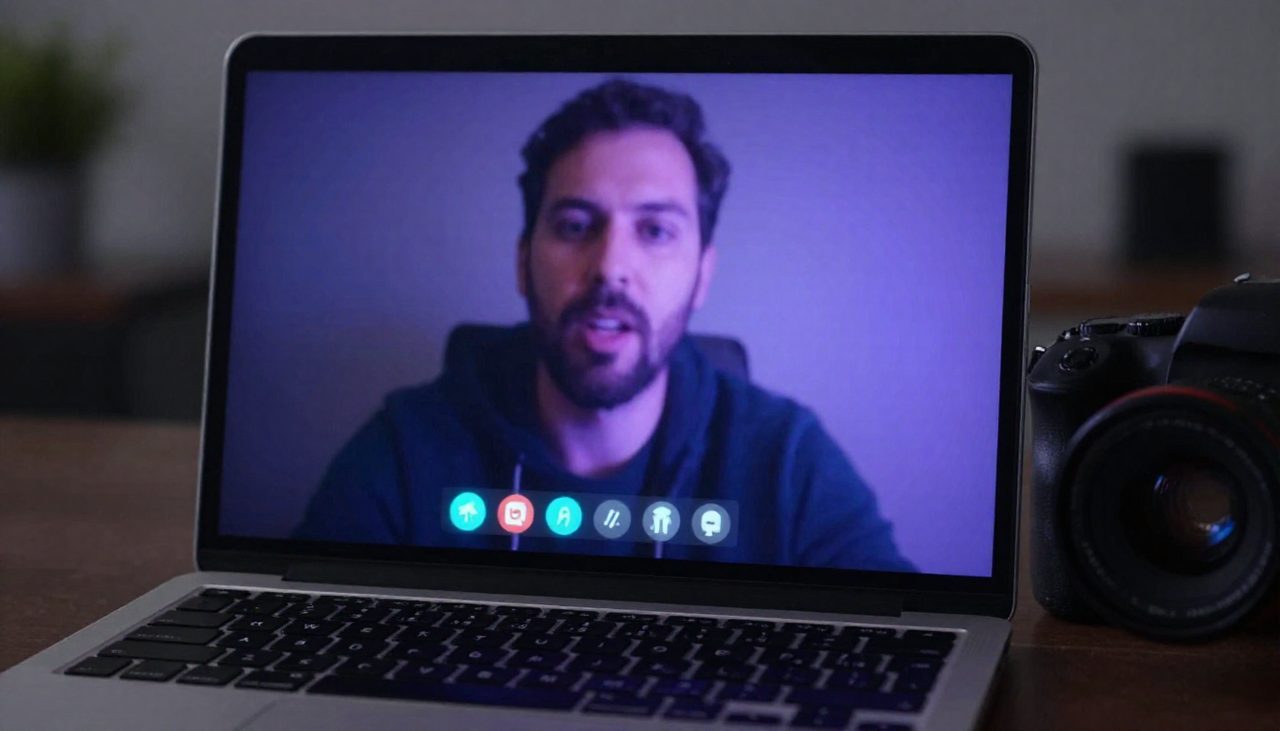
A lógica de verificação baseada em 'ver para acreditar' é abalada, mas os critérios do teste foram definidos pela própria Tavus, e a prévia ainda não está aberta ao público
Antes de falar em 'ver para acreditar', considere estes números: em uma chamada de um minuto com o Griffin-Lite, modelo em versão de pesquisa da Tavus, 26 dos 54 participantes acreditaram que a pessoa na tela era humana, cerca de 48%; já o sistema anterior, no mesmo processo, enganou apenas 1 dos 41 participantes, uma taxa de erro de 2,4%.
Com base nisso, a Tavus define o Griffin como o primeiro modelo a passar no «Teste de Turing por Vídeo» em tempo real, e o classifica em uma nova categoria: Human Interaction Model (modelo de interação humana, HIM). Até o fechamento desta reportagem, quase 17,36 milhões de pessoas haviam assistido ao experimento online. Porém, o «primeiro a passar» continua sendo uma definição da própria Tavus sobre seus resultados, e o modelo ainda não tem prévia aberta a todos — a possibilidade de ser apenas uma demonstração promissora não pode ser descartada.
O verdadeiro destaque técnico deste lançamento está na mudança de paradigma de interação: da arquitetura em cascata para o full-duplex. Os sistemas em cascata comuns encadeiam reconhecimento de fala, resposta do modelo de linguagem, síntese de voz e animação do avatar digital em um fluxo: o usuário termina de falar para o sistema processar. O Griffin, por sua vez, emite voz e imagem enquanto continua recebendo áudio e vídeo do usuário. Seu motor de modelagem de conversação contínua reavalia o estado da interação em intervalos inferiores a um segundo, decidindo o que dizer e quando intervir a partir da expressão, do olhar, do tom e das pausas do interlocutor, além de gerar sinais de controle de emoções, expressões e movimentos, entregues ao motor de geração de áudio e vídeo para produzir som e imagem contínuos. Diante de um mesmo silêncio, ele precisa distinguir se a pessoa está pensando, já terminou de falar ou espera que o outro continue explicando — detalhes além da linguagem que, justamente, são os que mais entregam uma IA na conversa.
O escopo da geração visual também se expandiu. Segundo a Tavus, o Griffin consegue gerar em tempo real uma cena inteira a partir de uma única imagem de referência, incluindo rosto, braços e dedos do personagem, além do movimento da cadeira, sombras e mudanças no fundo; assim, o avatar pode assentir, ajustar o olhar ou mudar de expressão já durante a escuta, sem esperar a vez de falar. As demonstrações oficiais incluem ainda um jogo de imitação de comandos, interação com um cubo mágico e observação do usuário soldando uma placa de circuito. Quando até a imagem da câmera pode ser gerada em tempo real, a premissa de tratar abrir o vídeo como a última garantia de confirmação de identidade precisa ser reavaliada.
Tags: Tavus · Griffin · Video Turing Test · Full-Duplex · Human Interaction Model · Digital Human
萬安算交所 AIXX · AIXX · Exchange verificado · Ir ao mercado